第三部分 – 函数、内存与名称空间
第三部分:函数、内存与名称空间一、基本知识
1. 函数包括没有返回值的函数(void函数)、有返回值的函数。
函数的原型声明格式 返回类型 函数名(形参列表);
函数的定义的格式 返回类型 函数名(形参列表);
2. 没有返回值的函数(void函数) 通用格式:
void 函数名(形参列表)
{
语句
return;//可选
}
返回语句是可选的,意味着void函数的结束。通常函数在右花括号处结束。
3. 有返回值的函数 通用格式:
返回类型名 函数名(形参列表)
{
语句
return 返回值;
}
有返回值的函数必须使用返回语句,返回值可以是常量、变量或表达式。返回值不能是数组!
函数的形参列表可以为空,可以有多条return语句
4. 函数原型
(1) 为什么需要原型:函数原型可以指出函数的特征
(2) 原型的语法:函数原型可以不提供变量名,有类型列表足矣。
(3) 原型的功能:
·使编译器正确处理函数返回值
·使编译器检查使用的参数数目是否正确
·使编译器检查使用的参数类型是否正确;若不正确可以进行类型转换。
·通常原型自动将被传递的参数强制转换为期望的类型。
注意:·仅当有意义时,原型化导致类型转换。
·在编译阶段进行的原型化被称为静态类型检查,可以捕获许多在运行期间难以捕获的错误。
note:在C++中,括号为空与在括号中使用void等效。ANSI C中括号为空意味着不指出参数(参数由定义指出)。C++中不指定参数列表用省略号(…)。
二、函数参数、按值传递、函数作用域
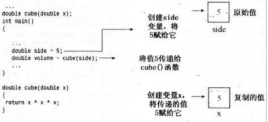
1. C++通常按值传递参数,即将数值参数传递给函数,并赋给新的变量。
e.g. 函数原型是double cube(double x),则cube(3)调用时把x赋值为3.此处的x是一个新的变量,不影响调用函数。
2.用于接受传递值的变量称为形参。传递给函数的值为实参。以上例子x为形参,3为实参。
C++标准(以下简称“标准”)使用参数(argument)表示实参,使用参量(parameter)来表示形参。参数会赋给参量。
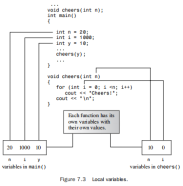
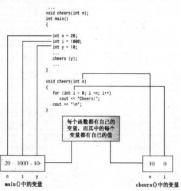
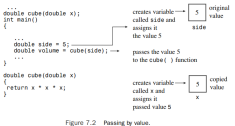 3.函数的内存是专用的,并且函数内的变量不会影响外部的同名变量,在执行完毕后函数释放内存。这些变量叫局部变量,也叫自动变量,在执行过程中自动分配释放。
 4.形参可以用=指定默认参数,注意按值传递时不允许中间断开,只能在末尾的参数指定默认参数。
三、函数与数组
1.示例代码:int sum(int arr[],int n)
函数的形参中没有数组,只有指针。但是在函数中仍然可以像使用数组一样使用它。在示例中arr是一个指针,绝非数组。
当(且仅当)在函数头或函数原型中,int *arr和int arr[]的含义相同。
注意:传递数组传递了数组的地址,也是按值传递,不过使用的仍然是原来的数组。
在以上实例中,若arr1是一个8个元素的int数组,sizeof arr1的值为32.而arr1作为参数传递给sum后,sizeof arr为4(32位系统)或8(64位系统).
★★★★★2.[易混淆点]指针与const
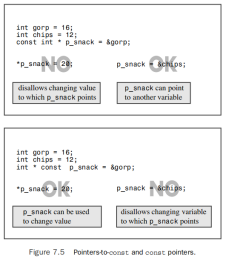
①.指针可以指向const值(Pointers-to-const),此时指针指向的地址可以修改,但是指向的内容不可以修改;指针变量本身也可以是const值(const Pointers,const指针),此时指针指向的地址不能修改,指向的内容可以修改;const指针指向const值时,指针和指向的值都不能修改。
注意:要区别是指针的值还是指向的对象的值能修改。
②指向常量的指针pt
int age=39;
const int *pt=&age;
以上的声明指出,pt指向const int(此处为39),不能用pt修改age(因为*pt理应是const int),但是可以用age来修改自己的值。在此处的声明不一定意味着pt指向的值一定是const,而是相对于pt而言,它指向的值是const.
③可以把常规变量赋给常规指针,可以把常规变量赋给指向const的指针,可以把const变量的地址赋给指向const的指针,但是不可以将const变量的地址赋给常规指针。
④涉及一级间接关系时可以将非const指针赋给const指针。(一级间接关系类似Type_ *p;)
note:要在函数的形参中尽可能使用const
⑤禁止将const数组的地址赋给非pointers-to-const指针。
⑥.无法修改指针值的指针
int sloth-3;
const int *ps=&sloth;
int * const finger=&sloth;
以上代码中finger只能指向sloth,但允许使用finger修改sloth的值。不允许使用ps来修改sloth的值,但允许ps指向另一个值。finger和*ps都是const,*finger和ps不是。
 double trouble=2.0E30;
const double * const stick=&trouble;
在此处stick和*stick都是const.stick只能指向trouble,stick也无法修改trouble.
⑦总结:
指向const的指针:const 指向类型 *指针名=值;
*指针名指向的类型
const指针: 指向类型 * const 指针名=值;
说明是一个指针
指向const的const指针:
const 指向类型 *const 指针名=值;
3.函数与二维数组
int data[3][4]={{1,2,3,4},{9,8,7,6},{2,4,6,8}};
int total=sum(data,3);
以上代码中data是一个数组,第一个元素是由4个int构成的数组。
则sum()的原型如下:
int sum(int (*ar2)[4],int size);
其中的括号必不可少。int *ar2[4];声明一个由4个指向int的指针组成的数组。加上括号则声明一个指向由4个int组成的数组的指针
note:数组与指针的一些声明该如何看?
数组声明 Type_ arrname[length];
此时先看前面的Type_ arrname,这里指出了数组元素的类型是Type_和arrname是一个数组。
指针声明 Type_ *pointername;
此时*pointername是一个Type_类型的数据,则pointername应该是一个指向Type_类型的指针。同理当声明是Type_ **p;时,**p是Type_类型,*p是Type_*类型,**p为Type_**.
当声明是Type_ (*p_name)[length];时,由于小括号的优先级大于中括号,则应当把(*p_name)看作一个整体。此时(*p_name)是一个有length个Type_组成的数组,则p_name就是指向数组的指针了。 警告:在实际工作中请使用简洁明了的声明,不复杂化声明。
在函数原型中也可以写成这样:int sum(int ar2[][4],int size);可读性更好
在函数的定义中可以把ar2看作数组的名称。由于ar2指向数组,ar2+r表示二维数组的第r行,所以ar2[r][c]的表达方式可以用在ar2上.
5. 函数与C风格字符串:注意字符串可能需要使用const关键字定义函数。
接受字符串时不需要传递长度,因为有‘\0’。’\0’的ASCII码为0,则可以用循环条件判断它。函数不能返回字符串,但是可以返回其地址。
四、函数与其他类型
·数学库(cmath)的atan2(y,x)可以根据x和y计算角度。(tanα=y/x,此处的库函数在已知y和x的情况下求α)。atan()不能区分180之内和之外的角度。
·传递结构可以用直接按值传递和传递结构的地址。传递地址节省时间空间。
五、递归
·函数调用自己叫递归(类似于数学中的递归定义),C++中main()不能调用自己
·包含一个递归调用的递归:void函数的递归的一般形式如下:
void 函数名(形参)
{
statements1
if(text)
函数名(实参);
statements2
}
递归要有退出的条件,让调用链断开。在每次递归调用时,控制权交给新调用的函数,而后调用链断开时逐渐返回。
note:函数调用时会将返回地址和函数实参压入栈中(与汇编call与ret指令有一定关系)。栈空间是有限的,切勿进行过多递归调用。
·包含多个递归调用的递归
在需要将一件工作不断分为两项较小的、类似的工作时,使用递归,可以将同样的操作用于每一部分,有时也叫分而治之策略。
实例:(摘自C++ Primer Plus)
// ruler.cpp — using recursion to subdivide a ruler
#include <iostream>
const int Len = 66;
const int Divs = 6;
void subdivide(char ar[], int low, int high, int level);
int main()
{
char ruler[Len];
int i;
for (i = 1; i < Len – 2; i++) ruler[i] = ‘ ‘;
ruler[Len – 1] = ‘\0’;
int max = Len – 2;
int min = 0;
ruler[min] = ruler[max] = ‘|’;
std::cout << ruler << std::endl;
for (i = 1; i <= Divs; i++)
{
subdivide(ruler,min,max, i);
std::cout << ruler << std::endl;
for (int j = 1; j < Len – 2; j++)
ruler[j] = ‘ ‘; // reset to blank ruler
}
// std::cin.get();
return 0;
}
void subdivide(char ar[], int low, int high, int level)
{
if (level == 0) return;
int mid = (high + low) / 2;
ar[mid] = ‘|’;
subdivide(ar, low, mid, level – 1);
subdivide(ar, mid, high, level – 1);
}
| |
| | |
| | | | |
| | | | | | | | |
| | | | | | | | | | | | | | | | |
| | | | | | | | | | | | | | | | | | | | | | | | | | | | | | | | |
|||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
▲▲▲▲▲六、函数指针(指向函数的指针,简称函数指针,Pointers to Functions)
1. 函数的地址是存储其机器语言代码的内存的开始地址。
2. 函数名(后面不跟参数)就是函数的地址。如a()是函数,a就是它的地址。
即 函数名(参数列表) 是函数调用,而 函数名 是其地址。
function1(a());
function2(a);
以上的代码会先调用函数a(),将其返回值传递给function1()函数。而函数a()的地址a被直接传递给function2()
3. 声明函数指针:注意函数指针要包含函数的返回类型和函数的特征标(参数列表)。
若函数原型是 double pam(int);
则函数指针的声明如下: double (*pf)(int);
这里的(*pf)与pam都是函数,则pf就是函数指针了。
注意:必须使用括号将*pf括起。括号的优先级比*高,则double *pf(int);意味pf()是一个返回指针的函数,(*pf)(int)意味着pf是一个指向函数的指针。
此时可以将相应的函数的地址赋给pf,特征标和返回类型都必须相同,若不相同,编译器会拒绝这种赋值。
4. 使用函数指针调用函数:在以上实例中(*pf)相当于函数名,所以在它后面加上参数列表可以调用函数。也可以使用pf来进行调用。
double pam(int);
double (*pf)(int);
pf=pam;
double x=pam(4);
double y=(*pf)(5);//两种格式可以互换
y=pf(5);
note:pf与(*pf)等价的原因:一种说法是由于pf是函数指针,*pf是函数,因此(*pf)()是函数调用;另一种说法是函数名是指向该函数的指针,指向函数的指针应与函数名相似,所以pf();可以作为函数调用。C++允许两种写法。
5. 总结:函数指针的声明:
返回类型 (*指针名)(形参类型列表);//可以使用auto初始化以达到简化的效果
示例:冒泡排序Bubble_Sort
#include<iostream>
using namespace std;
void bubble_sort(int*,bool (*)(int,int));
bool greaterthan(int,int);
bool smallerthan(int,int);
int main()
{
int arr1[10];
int arr2[10];
cout<<“键入10个数据以进行排序:\n“;
for(int i=0;i<10;i++)
{
cin>>arr1[i];
arr2[i]=arr1[i];
}
bubble_sort(arr1,greaterthan);
bubble_sort(arr2,smallerthan);
cout<<“从小到大:”;
for(int i=0;i<10;i++){cout<<arr1[i]<<” “;}
cout<<endl;
cout<<“从大到小:”;
for(int i=0;i<10;i++){cout<<arr2[i]<<” “;}
cout<<endl;
return 0;
}
void bubble_sort(int arr[10],bool (*condition)(int,int))
{
for(int i=9;i>0;i–)
{
for(int j=0;j<i;j++)
{
if(condition(arr[j],arr[j+1]))
{
int temp=arr[j+1];
arr[j+1]=arr[j];
arr[j]=temp;
}
}
}
}
bool greaterthan(int x,int y){return x>y;}
bool smallerthan(int x,int y){return x<y;}
键入10个数据以进行排序:
12 254 2323 -34 0 44 -23 0 10 1
从小到大:-34 -23 0 0 1 10 12 44 254 2323
从大到小:2323 254 44 12 10 1 0 0 -23 -34
6. 深入函数指针:部分函数的原型:
const double * f1(const double ar[],int n);
const double * f2(const double [],int);
const double * f3(const double *,int);
以上函数的特征标相同。
若要声明一个指针指向这3个函数,指针名为p1,此时将目标函数名换为(*p1)
得到:const double *(*p1)(const double*,int); 因为(*p1)是函数,则p1是函数指针
此时仅仅只是单值,所以可以用auto,当要初始化数组时,有初始化列表,不能用auto。
若要声明一个包含三个函数指针的数组,声明如下:
const double *(*pa[3])(const double*,int)={f1,f2,f3};
声明数组时需要使用pa[3],其他部分指明了数组的元素的特征,运算符[]的优先级高于*,因此*pa[3]表明pa是一个包含三个指针的数组。所以,pa是包含3个指针的数组,每个指针都指向以const double*和int作为参数,并返回const double*的函数。
若要声明pd指向pa,则声明如下:
const double *(*(*pd)[3])(const double*,int)=&pa;
由于(*pd)是一个数组,则pd就是一个指向数组的指针。
note:复杂声明拆解:
先从整体看。以上声明若是第一次遇见,则要先大致看。此处可以明确声明包括了函数指针,此时(*(*pd)[3])是函数,则((*pd)[3])是函数指针,(*pd)是一个有3个元素的数组,每个元素都是函数指针,则pd就是指向这个数组的指针。总结一下,pd是指向一个有三个元素,每个元素都是指向接受const double*和int返回const double*的函数的函数指针。
原书程序:
#include <iostream>
const double * f1(const double ar[], int n);
const double * f2(const double [], int);
const double * f3(const double *, int);
int main()
{
using namespace std;
double av[3] = {1112.3, 1542.6, 2227.9};
const double *(*p1)(const double *, int) = f1;
auto p2 = f2;
cout << “Using pointers to functions:\n“;
cout << ” Address Value\n“;
cout << (*p1)(av,3) << “: “ << *(*p1)(av,3) << endl;
cout << p2(av,3) << “: “ << *p2(av,3) << endl;
const double *(*pa[3])(const double *, int) = {f1,f2,f3};
auto pb = pa;
cout << “\nUsing an array of pointers to functions:\n“;
cout << ” Address Value\n“;
for (int i = 0; i < 3; i++)
cout << pa[i](av,3) << “: “ << *pa[i](av,3) << endl;
cout << “\nUsing a pointer to a pointer to a function:\n“;
cout << ” Address Value\n“;
for (int i = 0; i < 3; i++)
cout << pb[i](av,3) << “: “ << *pb[i](av,3) << endl;
cout << “\nUsing pointers to an array of pointers:\n“;
cout << ” Address Value\n“;
auto pc = &pa;
cout << (*pc)[0](av,3) << “: “ << *(*pc)[0](av,3) << endl;
const double *(*(*pd)[3])(const double *, int) = &pa;
const double * pdb = (*pd)[1](av,3);
cout << pdb << “: “ << *pdb << endl;
cout << (*(*pd)[2])(av,3) << “: “ << *(*(*pd)[2])(av,3) << endl;
return 0;
}
const double * f1(const double * ar, int n){return ar;}
const double * f2(const double ar[], int n){return ar+1;}
const double * f3(const double ar[], int n){return ar+2;}
Using pointers to functions:
Address Value
002AF9E0: 1112.3
002AF9E8: 1542.6
Using an array of pointers to functions:
Address Value
002AF9E0: 1112.3
002AF9E8: 1542.6
002AF9F0: 2227.9
Using a pointer to a pointer to a function:
Address Value
002AF9E0: 1112.3
002AF9E8: 1542.6
002AF9F0: 2227.9
Using pointers to an array of pointers:
Address Value
002AF9E0: 1112.3
002AF9E8: 1542.6
002AF9F0: 2227.9
·函数指针数组的通用套路:返回类型 (*指针名[元素个数])(形参类型列表)={函数列表};
·使用typedef简化声明:将别名当作标识符进行声明,在开头使用关键字typedef.如:
typedef const double *(*p_fun)(const double *, int); // p_fun now a type name
p_fun p1 = f1; // p1 points to the f1() function
注意:这里的p_fun是新的类型,而不是变量。
三、内联函数
在声明和定义前加上inline,一般省略声明,在main()函数前直接定义。
编译器用内联代码替换函数调用。因此,内联函数不可递归。
若函数简短且十分常用,可以使用内联函数。
note:内联与宏(#define)
由于宏是通过文本替换实现的,则#define SQUARE(X) X*X 在替换SQUARE(4.5+7.5)时会出现问题,此时加上括号,变成#define SQUARE(X) ((X)*(X)),但是SQUARE(C++)并不会先让C++递增再平方,而是替换为(C++)*(C++),显然不符合预期。所以要考虑把C宏换位内联函数。
四、引用变量
1. 引用是乙定义的变量的别名。
2. 创建:引用的类型 &引用名=被引用的变量;
如 int &a=b;其中int &指的是指向int的引用。引用与被引用的变量指向相同的值和内存单元。(变量名其实是对内存单元的标识,一个内存单元可以对应多个标识,所以所有的标识等效)
·必须在声明时将引用初始化,一旦与某个变量(被引用的变量)关联起来,就一直效忠于它,不能用赋值运算符修改。(在初始化后赋值运算符只能像常规变量一样使用)
3. 将引用作为函数参数(按引用传递)
·将引用作为函数参数叫做按引用传递。
·只有按引用传递才能修改调用函数中变量的值。如交换变量的函数需要引用。
·注意:传递引用会改变原变量的值,常规类型变量最好用按值传递。在传递结构变量和类对象时,用引用比较好。
·如果函数形参是引用,则应该传入一个变量,而不是一个常量或含有多项的表达式(如1+a)
部分情况下,程序会创建无名变量,将其初始化为传入的表达式,再去引用该变量。
·临时变量、引用参数和const
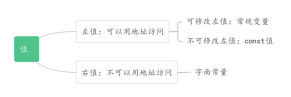 (1)左值:可以被引用的数据对象。变量、数组元素、结构成员、引用和解除引用的指针都是左值。非左值(右值)包括字面常量(用引号括起的字符串常量除外,其由其地址表示)和包含多项的表达式。左值可用地址访问,包括常规变量(可修改的左值)和const变量(不可修改左值)。
(2)编译器创建临时变量的情况:当引用参数为const时
实参的类型正确,但不是左值
实参的类型不正确,但可以转换为正确的类型
例子:
double refsqu(const double&);
int a=3;
double b=refsqu(a);//会创建临时变量
double c=refsqu(a+1);//会创建临时变量
note:最好尽可能使用const作为形参
(*).C++11新增了右值引用,可指向右值,用&&声明。用&声明的时左值引用。
4. 引用与结构、类对象
返回引用:传统的返回计算关键字return后的表达式的值,然后把值复制到一个位置以返回,然后调用函数再使用它。返回引用时无需拷贝值(此时函数相当于被引用变量的别名)。
注意:要避免返回指向函数终止时不在存在的变量的引用(指针)。可以返回一个作为参数传递给函数的引用或使用new关键字。
·不能通过地址访问的值叫做右值,这些表达式只能出现在赋值语句右边
·可以将C风格字符串用作string对象引用参数,因为string类定义了char* 到string的转换功能。注意:要使用const string&形参.
5. 对象继承和引用
·使得能够将特性从一个类传递给另一个类的语言特性叫做继承。
·ostream是基类,ofstream是派生类,派生类继承了基类的方法,可以使用基类的特性
·基类引用可以指向派生类对象,无需强制类型转换。如:将参数类型为ostream&的函数可以接受ostream对象和ofstream对象。
·ostream中的方法setf()可以设置格式化状态。其返回调用它之前所有有效的格式化设置,用ios_base::fmtflags类型来存储。
·setf(ios_base::fixed)设置定点表示法,方法precision(位数)在定点模式下指定显示多少位小数。setf(ios_base::showpoint)显示小数点,即使小数部分为0.这些设置在下次调用方法设置前一直保持不变。方法width(宽度)设置下一次输出操作使用的字段宽度,该设置在显示下一次值时有效,然后将恢复默认设置。
·给setf()传入之前保存的设置(ios_base::fmtflags类型的变量)可以恢复原有设置,如:
ios_base::fmtflags init_setting=cout.setf(ios_base::boolalpha);
……
cout.setf(init_setting);
五、默认参数
·默认参数指的是当函数调用中省略了实参时自动使用的一个值。在调用函数时可以选择覆盖默认值或直接使用默认值。
·使用:通过函数原型设置默认值。如:
char *left(const char*str,int n=1);
·对于带参数列表的函数,必须从右向左添加默认值。若要为某个参数设置默认值,则必须为它右边的所有参数提供默认值:
int a(int n,int m=0,int k=0);//可以
int b(int n,int k=0,int s);//不可以
int c(int n,int k,int s=0);//可以
六、函数重载
·多态:有多种形式
·函数重载(多态):可以有多个同名的函数,重载的函数特征标应该不同。
·函数特征标:函数的参数列表(函数参数数目和类型,参数的排列顺序)与变量名、返回类型无关。
·编译器根据所采取的用法使用使用有相应特征标的原型。
·若没有匹配的原型,会尝试进行强制类型转换以匹配。若匹配到多个函数(或有多种转换方式),编译器会拒绝这种函数调用。
·编译器检查函数特征标时,把类型引用和类型本身视作同一特征标。
·匹配函数时,会区分const和非const变量。
void a(const int &);//#1
void a(int &);//#2
此时有函数调用a(b);若b为const int,则调用#1版本的函数,若b为int,调用#2版本的函数。编译器根据实参是否为const决定使用那个原型。
void staff(double & rs); // matches modifiable lvalue
voit staff(const double & rcs); // matches rvalue, const lvalue
void stove(double & r1); // matches modifiable lvalue
void stove(const double & r2); // matches const lvalue
void stove(double && r3); // matches rvalue
左值引用参数r1与可修改的左值参数匹配,const左值引用参数r2与可修改的左值参数、const左值参数和右值参数匹配;右值引用参数r3与右值匹配。此时调用stove()函数时会调用最匹配的版本。若没有定义stove(double &&),stove(x+y)将调用函数
stove(const double&)。
·重载示例:实用示例8-1
任务1:分离数字各位
#include<iostream>
using namespace std;
int main()
{
int n;//输入一个数字n进行操作
cin>>n;
while(n!=0)//核心部分
{
cout<<n%10<<” “;
n/=10;
}
return 0;
}
1428579
9 7 5 8 2 4 1
分析:此程序的原理可以类比十进制转换为二进制,十进制转换为二进制用除2取余法,此时可以知道每一位分别是什么。那么,“将十进制转换为十进制”时,除10取余可以看出每一位是什么。
输入1428579,首先计算1428579%10,得到最后一位9,然后1428579/10,得到142857,消去了一位,计算142857%10,得到最后一位7,……依次类推,在计算到1/10时,变量n=0,循环结束。
任务2:计算整数位数:类比任务1,每次除以10去掉一位。
任务3:编写left()函数,返回字符串前n位或整数前n位。
1. left()实现:
2. 组成程序。
note:编译器处理函数重载时使用名称修饰(矫正),根据形参类型标注函数。
七、函数模板
·函数模板是通用的函数描述。
–>函数模板用泛型来定义函数,其中的泛型可以用具体的类型替换。
–>通过将类型作为参数传递给模板,可使编译器生成该类型的函数。
·模板特性也叫参数化类型。
示例:交换变量的模板
template
void Swap(AnyType &a,AnyType &b)
{
AnyType temp;
temp=a;
a=b;
b=temp;
}
第一行的template指出要创建一个模板,关键字typename指出AnyType是一个类型,类型名可任意选择,可用关键字class代替typename.(两个关键字等价)
声明模板的格式:template
▲模板不会创建任何函数,而是指出如何定义函数。
在以上例子中,若要交换int值,编译器把AnyType用int替换。
·在最终的代码中不包含任何函数定义,只包含为了程序生成的实际函数。
1. 模板重载:函数特征标必须不同。并非所有的模板参数都必须是模板参数类型
2. 显式具体化(explicit specialization)
·显式具体化是为特定类型提供的具体化函数定义。
·当编译器找到与函数调用匹配的具体化定义时,将使用该定义,而不再寻找模板。
▲▲标准:第三代具体化
·对于给定的函数名,可以有非模板函数、模板函数和显式具体化模板函数以及它们的重载版本
·显示具体化的原型定义应以template<>打头,并通过名称来指出类型
·具体化优先于常规模板,非模板函数优先于具体化和常规模板
(优先顺序:非模板函数、具体化模板函数、常规模板函数)
下面是用于交换job结构的具体化:
template <> void Swap
格式:template<> 返回类型 函数名<具体化类型>(形参列表);
或者 template<> 返回类型 函数名(形参列表);
3. 实例化和具体化
·编译器使用模板为特定类型生成函数定义时,得到的是模板实例(instantiation).模板并非函数定义,模板实例是函数定义。
·函数调用使编译器产生实例的实例化方法是隐式实例化(implicit instantiation).
·显式实例化(explicit instantiation):直接命令编译器创建特定的实例。语法:
template 返回类型 函数名<实例类型>(形参类型列表);
模板函数名<实例类型>() 表示模板函数的特定实例类型的函数调用。如Swap
此处Swap
·可以使用函数来创建显示实例化,语法:模板函数名<实例类型>(实参列表);
此时可以将实参强制转换为实例类型。如Add
·隐式实例化、显式实例化、显式具体化统称具体化(specialization)
note:显示具体化是针对特殊(特定)的类型,定制出不同于通用(常规)模板的方案,两种实例化虽然也针对特定的类型,但却使用通用(常规)的模板生成。
4. 编译器选择函数
编译器选择函数的过程:重载解析:步骤:
(1)创建候选函数列表(所有同名函数、模板) (2)创建可行函数列表(参数数目正确) (3)确定是否有最佳的可行函数,有则使用,没有则出错
确定最佳的可行函数时,可能进行转换,从最优到最后的顺序如下:
(1)完全匹配(2)提升转换(如整型提升)(3)标准转换(4)用户定义的转换
·完全匹配与最佳匹配
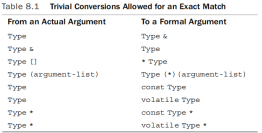 进行完全匹配时,允许某些无关紧要的转换,下表中Type为任意类型,Type (argument-list)表示用作实参的函数名与用作形参的指针只要返回类型和参数列表相同,就是匹配的。
有时候两个函数完全匹配也可以完成重载解析。
▲指向非const的指针(引用)优先与非const指针(引用)匹配,const与非const之间的区别只适用于指针和引用,否则会导致二义性。
·如果两个完全匹配的函数都是模板函数,则较具体的模板函数优先。(如显示具体化优于隐式生成的具体化):
template
template <> void a
string x;
a(x);//调用#2
·最具体(most specialized):编译器推断使用那种类型时执行的转换最少。
template
template
struct blot {int a; char b[10];};
blot ink = {25, “spots”};
recycle(&ink); // address of a structure
此时调用的应该是#2.
·用于找出最具体的模板的规则叫做函数模板的部分排序规则。
原书示例:// tempover.cpp — template overloading
#include <iostream>
template <typename T> // template A
void ShowArray(T arr[], int n);
template <typename T> // template B
void ShowArray(T * arr[], int n);
struct debts
{
char name[50];
double amount;
};
int main()
{
using namespace std;
int things[6] = {13, 31, 103, 301, 310, 130};
struct debts mr_E[3] =
{
{“Ima Wolfe”, 2400.0},
{“Ura Foxe”, 1300.0},
{“Iby Stout”, 1800.0}
};
double * pd[3];
for (int i = 0; i < 3; i++) pd[i] = &mr_E[i].amount;
cout << “Listing Mr. E’s counts of things:\n“;
ShowArray(things, 6); // uses template A
cout << “Listing Mr. E’s debts:\n“;
ShowArray(pd, 3); // uses template B (more specialized)
return 0;
}
template <typename T>
void ShowArray(T arr[], int n)
{
using namespace std;
cout << “template A\n“;
for (int i = 0; i < n; i++) cout << arr[i] << ‘ ‘;
cout << endl;
}
template <typename T>
void ShowArray(T * arr[], int n)
{
using namespace std;
cout << “template B\n“;
for (int i = 0; i < n; i++) cout << *arr[i] << ‘ ‘;
cout << endl;
}
Listing Mr. E’s counts of things:
template A
13 31 103 301 310 130
Listing Mr. E’s debts:
template B
2400 1300 1800
ShowArray(pd, 3); 该函数调用与模板A、B都匹配,模板B更具体,指出了数组内容是指针,因此而被使用。
·创建自定义选择
使用 函数名<>(参数列表); 的形式时,编译器选择模板函数,而不是非模板函数。
注意:即使去掉<>后有相应的非模板函数,编译器在发现<>后也不使用。
5. C++11:类型推导关键字decltype
int x;
decltype(x) y;
则此时的y与x的类型相同。可以给decltype()提供表达式,推导表达式结果的类型。
若有以下声明 decltype(expr) var; 则编译器会这样核对类型:
step 1:若expr是没有用括号括起的标识符,var的类型应该与该标识符类型相同,包括const等限定符
step 2:若expr是一个函数调用,则var类型与函数返回类型相同
step 3:若expr是以一个左值,则var为指向其类型的引用。(注意:只有不符合前面所有步骤才进入第三步,则当expr是用括号括起的标识符会进入第三步)
double xx=2.8;
decltype((xx)) r2=xx; //r2 is double &
decltype(xx) w=xx;//w is double
▲括号不会改变表达式的值和左值性。
step 4:如果前面都不满足,var类型与expr类型相同
6. C++11后置返回类型
语法:auto 函数名(形参列表) -> 后置返回类型;
不能把decltype()放在前面,因为此时参数还未声明,不在作用域中
以下两行代码等价:
double h(int x,float y);
auto h(int x,float y) -> double;
此时double是后置返回类型,auto是占位符,表示后置返回类型提供的类型。
示例:
template
auto Sub(T1 a,T2 b)->decltype(a-b)
{
return abs(a-b);
}
八、单独编译
大型程序的源码可分为3部分:
头文件:结构、类声明和函数原型
源代码文件A:包含有关函数的实现
源代码文件B:调用这些函数、main()函数的所在文件
1.引入头文件:
#include”自定义头文件”
用于引入自定义的头文件,优先从使用头文件的源代码所在目录查找
#include<标准头文件>
优先从编译器存放头文件的位置查找,引入标准头文件(编译器扩展头文件也可以)
警告:不要用#include包含源代码文件
2.管理头文件的预处理指令
#ifndef 宏名称
预处理指令#ifndef(if not defined)用于检测某个宏是否已被#define定义。其与#endif一同使用,如果宏没有定义,则在编译时才会使用它们之间的代码,否则不使用。
#ifndef HEADER_1
int a=0;
#endif
如果HEADER_1宏被定义,则int a=0;这条声明被忽略,若HEADER_1没有定义这条声明有效。
#define 宏名称
#define可以只定义一个符号而不定义值,如#define HEADER_1
头文件的常用结构
#ifndef 宏
#define 宏
//代码
#endif
以上的做法依据如下:如果宏被定义,忽略代码和#define;若没有定义宏,则立马定义它,并使用#ifndef和#endif之间的代码,在下次该文件再次被包含时就会忽略代码和#define,防止代码重复。
九、存储持续性、作用域和链接性
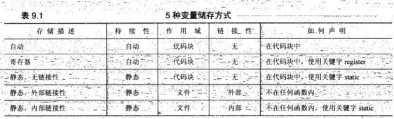
C++的存储持续性
·自动存储持续性:在函数定义中声明的变量和函数参数为自动存储持续性。在程序执行其所属函数(代码块)时创建,函数(代码块)执行完毕时释放。
·静态存储持续性:在函数定义外定义的变量、使用static关键字定义的变量为此类型。在程序的整个运行周期都存在。
·***线程存储持续性(C++11)
·动态存储持续性:用new分配的内存。生命周期知道delete运算符释放内存。
1. 作用域:描述名称在多大的范围内可见
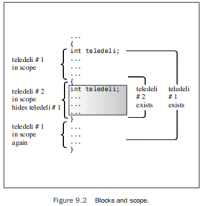 ·作用域为局部的变量仅仅只在定义它的代码块可用
·作用域为全局的变量在定义位置到文件结尾都可用
·自动变量的作用域为局部
·函数原型作用域中使用的名称只在包含参数列表的括号可见。
·类中声明的成员的作用域为整个类
·在名称空间中声明的变量的作用域为整个名称空间
·C++函数作用域为整个类(结构)或整个名称空间(包括全局)
2. 链接性:描述文件如何在不同单元间共享
·链接性为外部――可在文间共享
·链接性为内部――只能由一个文件中的函数共享
·自动变量没有链接性,无法共享
3. 自动存储持续性
note:早期版本的C++中auto关键字显示指出变量为自动存储。
当函数调用时,自动变量被加入栈中,栈顶指针移到变量后的下一个内存单元。函数结束时,栈顶指针重置为函数被调用前的值。
栈是LIFO(后进先出,late in first out)的,函数调用将参数压入栈中。
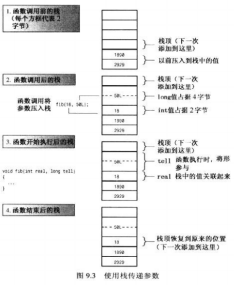 ·寄存器变量:
关键字register建议编译器使用CPU寄存器存储自动变量。C++11中变为显示指出变量是自动的。
4. 静态持续变量(3种链接性)
·编译器会分配固定内存块存储静态变量
·没有显式初始化静态变量时,编译器将其设为0;静态数组与结构每个元素(成员)会设为0。
·创建静态持续变量:
–>链接性为外部:在代码块外声明即可(常规语法)
–>链接性为内部:在代码块外声明并在前面加上static.
语法: static 类型 名称=值;
–>无链接性:在代码块内声明并在前面加上static.
·未被初始化的静态变量所有位都设为0,这种变量被称为零初始化的。
 ·静态变量的初始化
–>静态变量还能进行常量表达式初始化和动态初始化(运行阶段初始化)
–>零初始化+常量表达式初始化=静态初始化(编译阶段初始化)
–>所有的静态变量都先被零初始化,然后若用常量表达式初始变量,且编译器可根据文件内容计算表达式的值,编译器就会进行常量表达式初始化。没有足够的信息(如遇到库函数)时,变量会被动态初始化。
常量表达式还可以使用sizeof运算符。
5. 静态持续性&外部链接性
·外部变量:链接性为外部,存储持续性为静态,作用域为整个文件,在函数外部定义,也叫全局变量。
·单定义规则:变量只能有一次定义
·C++的两种变量声明:
–>定义声明:简称定义,给变量分配存储空间。
–>引用声明:简称声明,不给变量分配存储空间,引用已有的变量
·引用声明使用关键字extern,且不进行初始化。若初始化,会成为定义并分配空间
引用外部变量 extern 类型 变量名;//不许初始化
创建外部变量 extern 类型 变量名=值;
只需在一个文件中包含该变量的定义,其他玩家都必须使用关键字extern声明它。
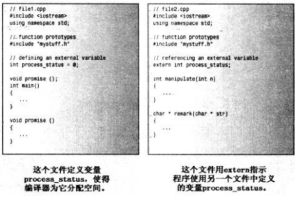 注意:单定义规则不代表不能有多个变量的名称相同。每个变量都是独立的,只有一个声明。
·在定义与全局变量相同的局部变量后,局部变量隐藏全局变量。
·访问变量的全局版本:::变量名
::叫做作用域解析运算符
在使用外部的函数时,只需声明原型
6. 静态持续性&内部链接性
文件中的静态变量(static变量)会隐藏常规外部变量。
原书示例:
twofile1.cpp
// twofile1.cpp — variables with external and internal linkage
#include <iostream> // to be compiled with two file2.cpp
int tom = 3; // external variable definition
int dick = 30; // external variable definition
static int harry = 300; // static, internal linkage
// function prototype
void remote_access();
int main()
{
using namespace std;
cout << “main() reports the following addresses:\n“;
cout << &tom << ” = &tom, “ << &dick << ” = &dick, “;
cout << &harry << ” = &harry\n“;
remote_access();
// cin.get();
return 0;
}
twofile2.cpp
// twofile2.cpp — variables with internal and external linkage
#include <iostream>
extern int tom; // tom defined elsewhere
static int dick = 10; // overrides external dick
int harry = 200; // external variable definition,
// no conflict with twofile1 harry
void remote_access()
{
using namespace std;
cout << “remote_access() reports the following addresses:\n“;
cout << &tom << ” = &tom, “ << &dick << ” = &dick, “;
cout << &harry << ” = &harry\n“;
}
main() reports the following addresses:
0x403010 = &tom, 0x403014 = &dick, 0x403018 = &harry
remote_access() reports the following addresses:
0x403010 = &tom, 0x403020 = &dick, 0x403024 = &harry
7. 静态存储持续性&无链接性
无链接性的局部变量声明:在局部变量声明前加上static.只在其所在的代码块中可用,但是其一直存在。若其在函数中,两次函数调用之间静态局部变量的值保持不变。如果初始化了静态局部变量,则程序只在启动时进行一次初始化,以后在调用时,不会再进行初始化。
#include<iostream>
using namespace std;
int times(void)
{
static int calledTimes=1;
return calledTimes++;
}
int main()
{
cout<<“第一次”<<times()<<“\n第二次“<<times();
return 0;
}
第一次1
第二次2
8. 说明符和限定符
(1)存储说明符
·auto(C++11之前)
·register
·static
·extern
·thread_local(C++11)
·mutable
(2)const和volatile(cv-限定符)
volatile表示即使程序代码没有对内存单元进行修改,其值也可能发生变化。
·默认情况下全局变量的链接性为外部,const全局变量链接性为内部。
·若要使得const链接性变为外部,加上extern
(3)mutable
用来指出即使结构(类)变量为const,某个成员也可以被修改。
9.函数的链接性
·默认情况下函数存储持续性为静态,函数的链接性为外部的。
·可在函数原型中使用关键字extern指出函数在另一个文件定义(可选)
·可以使用关键字static将函数的链接性设置为内部的,使之只能在一个文件中使用(必须在函数的定义和原型中都加上)
·静态函数将覆盖外部定义。
·内联函数不受单定义规则的约束。同一函数的所有内联定义必须相同
10.语言链接性
·链接程序要求每个不同的函数都有不同的符号名
·C语言链接性:一个名称对应一个函数,不会对函数名做过多的修饰
·C++语言链接性:同一名称对应多个函数,C++编译器进行名称矫正(修饰),为重载函数生成不同的符号名称。
·C++语言链接性与C语言链接性可能导致同一函数名链接时名称不同。
·在C++中使用C库预编译的函数:extern “C” 返回类型 函数名(形参类型列表);
·extern 语言 返回类型 函数名(形参类型列表);
以上的方法可以指定语言链接性,标准中规定了“C”、”C++”,不指出语言默认为C++。
十、存储方案与动态分配、定位new运算符
·动态内存由运算符new和delete控制。
1. 为标量类型分配存储空间并初始化:
int pi* = new int (6);//*pi设为6
double *pd=new double(99.99)//*pd设为99.99
概括:设T为标量类型,则分配存储空间并初始化语法如下:
T *指针名=new T(初始值);
2. 初始化常规结构、数组(C++11大括号列表初始化器)
struct where{double x;double y;double z;};
where *one=new where{31.13,26.00,82.2228};
int *ar=new int[4]{2,4,6,8};
该方法也可用于单值变量
3. new失败时引发异常std::bad_alloc
4. new:运算符、函数和替换函数
运算符new和new[]分别调用以下函数
void *operator new(std::size_t);
void *operator new[](std::size_t);
以上函数是分配函数,位于全局名称空间中。
运算符delete、delete[]调用释放函数:
void operator delete(void *);
void operator delete[](void *);
std::size_t为typedef。
int *pi=new int;被转换为int *pi=new(sizeof(int));
int *pa=new int[40];被转换为int *pa=new(40*sizeof(int));
C++中这些函数是可替换的,可进行定制(定制后使用定制的版本)。
5. 定位new运算符
头文件:new
用法:new(用于分配空间的地址) 类型;
new(用于分配空间的地址) 类型[分配的个数];
struct chaff
{
char dross[20];
int slag;
};
char buffer1[50];
char buffer2[500];
chaff *p1, *p2;
int *p3, *p4;
p1 = new chaff; // place structure in heap
p3 = new int[20]; // place int array in heap
p2 = new (buffer1) chaff; // place structure in buffer1
p4 = new (buffer2) int[20]; // place int array in buffer2
以上代码中new在buffer1中划出空间给一个chaff结构,在buffer2中划出空间给20个int.
定位new不需要delete,定位new可以重载
·其他形式的定位new
标准定位new调用一个接受两个参数的new()函数
int * pi = new int; // invokes new(sizeof(int))
int * p2 = new(buffer) int; // invokes new(sizeof(int), buffer)
int * p3 = new(buffer) int[40]; // invokes new(40*sizeof(int), buffer)
定位new运算符不可替换,其至少接受两个参数,第一个总为std::size_t,指定了请求的字节数。这些重载函数都被叫做定义new。
十一、名称空间
·声明区域:可以在其中进行声明的区域。全局变量的声明区域为其声明所在的文件,函数中声明的变量声明区域为其声明所在的代码块。
·潜在作用域:变量的潜在作用域从声明点开始,到声明区域的结尾。
·变量对程序而言可见的范围叫作用域。
·声明名称空间(使用namespace)
namespace 名称空间名
{
//各类声明
}
名称空间可以是全局的,也可以位于另一个名称空间(名称空间可以嵌套),不能位于代码块中。默认情况下名称空间中的名称链接性为外部。
·全局名称空间:对应文件级声明区域,全局变量位于全局名称空间中
任何名称空间中的名称都不会与其他名称空间中的名称发生冲突。
可以这样使用名称空间:
namespace grade_9
{
namespace segment_B
{
namespace class_15
{
void clean();
}
……
}
……
}
namespace grade_7
{
……
}
……
namespace grade_8
{
namespace segment_B
{
namespace class_15
{
void clean()
{
…….
}
}
}
}
·访问名称空间:使用作用域解析运算符::
如:grade_9::segment_B、grade_9::segment_B::class_15::clean() 即 名称空间名::名称
未被装饰的名称(clean())叫做未限定的名称,包含名称空间的名称叫限定的名称。
1. using声明:格式 using 限定的名称;
using声明将特定的名称添加到它所属的声明区域中。完成声明后,就可以用未限定的名称代替限定的名称。如using std::cout;可以让cout代替std::cout
2. using编译指令:格式 using namespace 名称空间;
using编译指令使名称空间中所有的名称都可用。
3. 无论是否使用using,都可以使用限定的名称。
4. 可以在其他名称空间中使用using.
namespace myth
{
using Jill::fetch;
using namespace elements;
using std::cout;
using std::cin;
}
在以上示例中,导入名称空间myth的同时也会导入elements,fetch即在名称空间Jill中也在名称空间myth中。
5. 给名称空间创建别名
namespace 别名=原名称空间名;
该方法可以用来简化对嵌套名称空间的使用:
namespace jjyz_g9c15=grade_9::segment_B::class_15;
jjyz_g9c15::introuduce();
此时jjyz_g9c15是grade_9::segment_B::class_15的别名。
6. 未命名名称空间:效果与链接性为内部的静态变量相似。潜在作用域为从声明点到该声明区域末尾。如:
static int counts;
namespace
{
int counts;
}
两种方式效果等价。